 FlowSentric
Eine Wissensdatenbank, der Ihr ganzes Team vertrauen kann
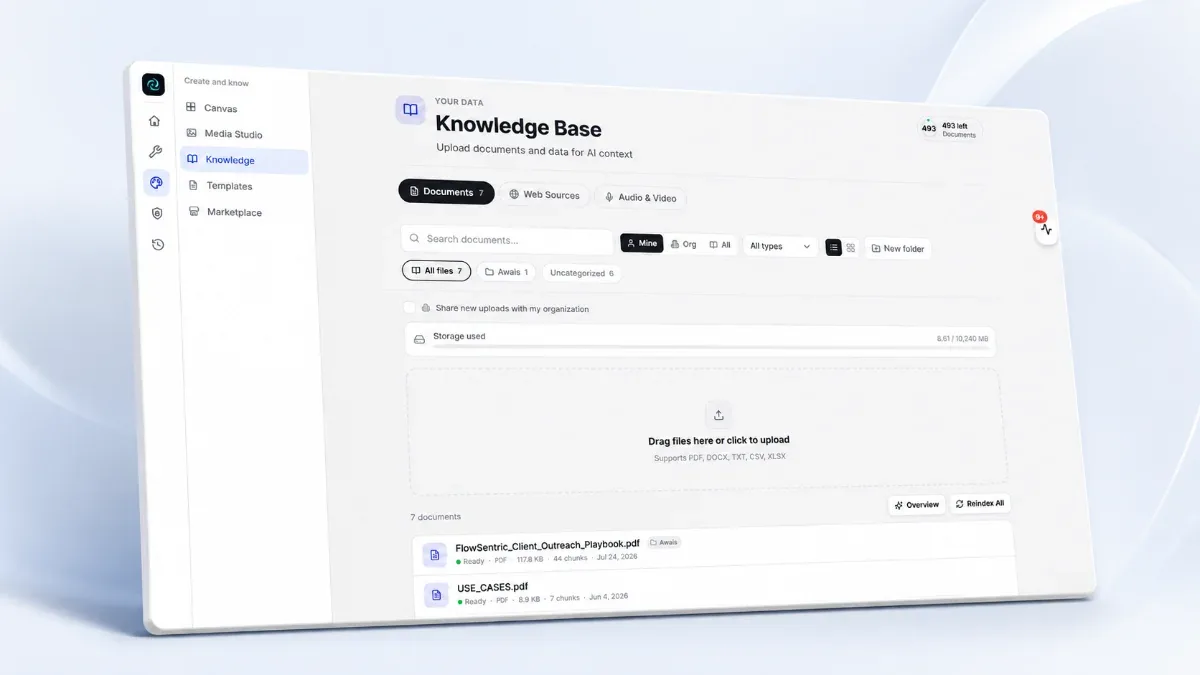
Laden Sie Verträge, Handbücher, Tabellen, Aufnahmen und Videos hoch. FlowSentric verankert jede Antwort in dem, was Sie tatsächlich bereitgestellt haben, und zitiert Dokument und Seite — auf Englisch und Deutsch.
Was es kann
Jedes Format, das Sie wirklich nutzen
PDF, Word, Excel, PowerPoint, CSV, Markdown, HTML, JSON, Bilder mit OCR — plus MP3, WAV, MP4, MOV und mehr, auf unseren eigenen Servern transkribiert. YouTube-Links und Podcast-Feeds importieren.
Zitierte Antworten, keine Halluzinationen
Hybride Suche kombiniert Vektorähnlichkeit mit Volltext-Ranking. Jede Antwort nennt ihre [Source: Dokument (Seite N)], und das Modell weiß genau, welche Dokumente existieren.
Privat by Construction
Persönliche oder Organisations-Sichtbarkeit pro Dokument, Ordner als Sammlungen, Versionshistorie mit Zurücksetzen und Privacy Guard, das abgerufenen Kontext maskiert, bevor er ein Modell erreicht.
So funktioniert es
Unter der Haube
Retrieval
- Hybride semantische + Stichwortsuche mit kombiniertem Ranking
- Optionales Reranking und Query-Erweiterung für präzisere Treffer
- Seitenbewusstes Chunking, damit Zitate auf die richtige Seite zeigen
Deutsch zuerst
- OCR liest Deutsch und Englisch; Umlaute und ß bleiben erhalten
- Volltextsuche auf german konfigurierbar (oder mehrere Sprachen zugleich)
- Vertrags-, Miet- und Rechnungslayouts vom Extraktor verarbeitet
Läuft auf Ihrem Server
- Embeddings mit mehrsprachigen Modellen auf unseren eigenen Servern — Text verlässt den Server zum Einbetten nicht
- Audio und Video transkribiert von einem lokalen Spracherkennungsmodell
- Optionales lokales Vision-Modell für Scans und Diagramme